Lepšie TAGS alebo tags
TAGS alebo tags je textový súbor, ktorý obsahuje index symbolov z kódu, napr. názvy funkcií, tried, makier, premenných, spolu s informáciou, kde nachádzajú ich definície. Ja to používam v každom programovacom jazyku. A prečo TAGS a tiež tags?
TAGS či tags?
To závisí. Teda — na tom, ktorý systém a editor človek používa. Tvoria ich programy ctags a etags (ten je distribuovaný priamo s Emacsom). Niektoré implementácie ctags dokážu vytvárať oba formáty.
Ale povedzme si najprv, na čo je to dobré.
Používa sa na:
- Skoky, takmer jelenie (akože veľké), na definíciu.
- Rýchlu navigáciu vo veľkom projekte.
- Automatické dopĺňanie (vraj, Emacs používa iný mechanizmus)
A ak ho vytvoríme pomocou programu ctags, tak má názov tags, ak pomocou programu etags, tak jeho názov je TAGS.
Formát tags (malé písmená) používajú editory z rodiny vi/Vim, formát TAGS (veľké písmená) je takmer výhradne doménou Emacsu a jeho derivátov.
Ostatné IDE používajú prevažne tags, či už natívne alebo pomocou pluginov.
Nasledujúca tabuľka uvádza jazyky a prípony rozpoznávané mojou používanou implementáciou ctags. Podpora jazykov, prípon a ďalších značiek sa môže líšiť podľa verzie a konfigurácie; ďalšie pravidlá možno v podporovaných implementáciách doplniť.
| Jazyk | Prípony / názvy súborov |
|---|---|
| ada | .ads .adb .ada |
| asm | .a .asm .def .inc .ins .s .sa .S .src |
| c | .c .h |
| c++ | .C .c++ .cc .cpp .cxx .H .h++ .hh .hpp .hxx .M .pdb |
| cobol | .COB .cob |
| erlang | .erl .hrl |
| forth | .fth .tok |
| fortran | .F .f .f90 .for |
| go | .go |
| html | .htm .html .shtml |
| java | .java |
| lisp | .cl .clisp .el .l .lisp .LSP .lsp .ml |
| lua | .lua .LUA |
| makefile | Makefile makefile GNUMakefile Makefile.in Makefile.am |
| objc | .lm .m |
| mercury | .m |
| pascal | .p .pas |
| perl | .pl .pm |
| php | .php .php3 .php4 |
| postscript | .ps .psw |
| proc | .pc |
| prolog | .prolog |
| python | .py |
| ruby | Rakefile Thorfile .rb .ru .rbw |
| rust | .rs |
| scheme | .oak .rkt .sch .scheme .SCM .scm .SM .sm .ss .t |
| tex | .bib .clo .cls .ltx .sty .TeX .tex |
| texinfo | .texi .texinfo .txi |
| yacc | .y .y++ .ym .yxx .yy |
Príklad súboru TAGS:
/home/richard/.arduino15/packages/industrialshields/hardware/avr/1.1.45/cores/industrialshields/WCharacter.h,1124
#define Character_h21,868
inline boolean isAlphaNumeric(26,936
inline boolean isAlpha(27,1005
inline boolean isAscii(28,1067
inline boolean isWhitespace(29,1129
inline boolean isControl(30,1196
inline boolean isDigit(31,1260
inline boolean isGraph(32,1322
inline boolean isLowerCase(33,1384
inline boolean isPrintable(34,1450
inline boolean isPunct(35,1516
Dnes sa intenzívne používa aj LSP (protokol na komunikáciu medzi editorom a „jazykovým serverom“, t.j. programom, ktorý analyzuje kód a poskytuje editoru inteligentné funkcie). Ja používam LSP pre Python a C, ale skôr na autodopĺňanie, ale v princípe systém ctags (etags) mi vyhovuje dostatočne.
Ako to funguje v Emacse?
Ak máme kurzor na názve funkcie, premennej, makre,… a stlačíme Hyper i alebo Meta ., alebo príkaz find-tag, podľa preferencií, tak Emacs pozrie do TAGS a skočí do potrebného súboru; ak tento ešte nie je otvorený, tak ho otvorí v ďalšom buffri.
Povedali sme si, že TAGS obsahuje čísla riadkov — a tie sa predsa menia pri editácii/pridávani/uberaní kódu v súbore. Podľa manuálu GNU Emacs netreba tabuľku značiek aktualizovať po každej úprave zdrojového kódu. Ak sa uložená pozícia trochu posunie, Emacs dokáže správne miesto dohľadať, najprv v okolí očakávanej pozície, prípadne prehľadať väčšiu časť súboru.
Príklad použitia
Syntax je rovnaká pre oba programy. Takže napríklad:
ctags -R . → vygeneruje súbor tags pre celý adresár a podadresáre
etags $(find . -name "*.c" -o -name "*.h") → vygeneruje súbor TAGS pre .c a .h súbory v aktuálnom adresári.
Makefile, 1. priblíženie k dokonalosti
Heh, „k dokonalosti“… to je prehnané. Ale ako je to teda u mňa?
Napr. slobodné PLC, ktoré majú v sebe nejakú otvorenú vývojovú dosku (typicky niečo z dielne Arduina, Espressifu atď.) programujem pomocou arduino-cli (udávam do pozornosti seriál Arduino (a kamaráti) bez IDE). A tam mám súbor make (ktorý načítava súbor s názvom Makefile, čo je textový súbor, ktorý obsahuje pravidlá a pokyny na automatizáciu úloh, najčastejšie na jeho kompiláciu a zostavenie.
Jeho časť:
program = bf-220.ino
tags:
    etags $(program) menu.h
Ak by som spustil príkaz make tags, tak by sa vykonalo: etags bf-220.ino menu.h a vytvoril sa súbor TAGS, ktorý obsahoval index definícií oboch súborov.
Žiadna veda a ani zázrak.
Makefile, 2. priblíženie k dokonalosti
Verte či nie, na 90% skokov na definície to postačuje. Ale prečo to nevylepšiť, že áno? Najmä, ak máme viacero .h a .cpp súborov, ktoré musíme zadávať ručne do parametrov etags
Aké knižnice vlastne používame?
Budem opisovať svoj spôsob práce, ktorý ale možno ľahko priohnúť na ľubovoľný.
Takže pri programovaní zariadení používam tieto knižnice:
- lokálne: sú tie v adresári samotného projektu,
- vlastné: tie, ktoré som si stiahol a nainštaloval alebo vytvoril ako univerzálne pre viac projektov,
- systémové: tie sú súčasťou a chodia priamo s nástrojmi pre tú-ktorú vývojovú dosku.
Pre svoje účely som si vytvoril takýto Makefile (krátené):
PROGRAM ?= $(wildcard ./*.ino)

HW_LIB ?= $(strip $(shell awk -F'=' '/^[[:space:]]*HW_LIB[[:space:]]*=/ {print $$2; exit}' $(PROGRAM)))

ifeq ($(HW_LIB),none)
$(info HW_LIB nie je definovaný)
HW_LIB :=
else ifeq ($(HW_LIB),)
$(info V súbore $(PROGRAM) sa nenašlo // HW_LIB=...)
HW_LIB :=
endif
⁞
⁞
⁞
tags:
        ~/coding/arduino/projecttags/ptags.sh $(HW_LIB)
Takže ako vidíme, tak pri pravidle tags spúšťame bashový skript ptags.sh, ktorý môže mať ešte voliteľný parameter HW_LIB?
Tento parameter môže byť zadaný priamo v tele .ino súboru a hovorí, kde sa nachádzajú systémové (lepší výraz by bol „hardvérové“) knižnice.
Ukážka:
/* Softvér na riadenie plniča paliet pomocou MDuino58+

   poznámky v súbore "project_info.org"

         ---- v. 1.5 ----

         HW knižnice pre "make tags"
         HW_LIB = industrialshields/hardware/avr

*/
Ako sme na to došli?
Ja používam iba arduino-cli (pre viac info prosím „hodiť očkom“ na spomínaný seriál), ale tuším aj IDE priamo od Arduina používa nejaký adresár, kde ukladá definície vývojových dosiek, príslušné knižnice a tiež nástroje na zostavovanie a nahrávanie softvéru (prekladače pre AVR, ARM atď).
U mňa:
$ cd ~/.arduino15/packages/ && ll

total 20k
drwx------   4 richard        richard  4k 2022-09-19  2022 arduino
drwx------   3 richard        richard  4k 2026-09-25 12:19 builtin
drwxr-xr-x   4 richard        richard  4k 2026-10-21 17:11 esp32
drwx------   4 richard        richard  4k 2024-03-27  2024 industrialshields
drwxr-xr-x   4 richard        richard  4k 2026-10-23 18:39 rp2040
Takže ja tam mám dosky:
- originál arduino (uno, leonardo, mega,…),
- esp32 (kdejaké varianty),
- industrial shields (nástroje a definície pre rovnomenné PLC),
- rp2040 (pre dosky Raspberry Pi Pico).
To znamená, že ak chceme tvoriť TAGS aj z knižníc, ktoré sa dodávajú s príslušnými doskami, musíme si definovať v HWLIB koncovú časť cesty, napr. industrialshields/hardware/avr alebo hoci i esp32/hardware/esp32.
O programe ptags.sh
Tento program, pri tvorbe ktorého som si pomohol s LLM (zase) s tvorbou regulárnych výrazov, teda robí toto:
- v aktuálnom adresári projektu nájde
.inosúbor a v ňom pohľadá „naincludované“ knižnice. - Potom hľadá v mojich knižniciach a
- nakoniec, ak sú definované, tak aj v systémových (hardvérových).
- A následne vytvorí TAGS súbor.
Pár riadkov kódu:
Definícia ciest:
SYS_LIBS="$HOME/.arduino15/packages/$1"
MY_LIBS="$HOME/coding/arduino/libraries"
LOCAL_LIBS="./ ./src ./lib ./libraries"
To je myslím dosť opisné.
Vytiahnutie „includov“:
INCLUDES=$(grep -h "^#include" *.ino *.h *.cpp 2>/dev/null | grep -oE "[A-Za-z0-9_.-]+\.h" | sort -u)
Nájde v lokálnom projekte riadky s #include, zistí ich hlavičkové súbory, zoradí ich a odstráni duplicity.
Vyhľadanie ciest ostatných knižníc:
DIRS="./"
for i in $INCLUDES; do
    # hľadá najprv v mojich knižniciach, potom v systémových
    D=$(find $LOCAL_LIBS "$MY_LIBS" "$SYS_LIBS" -type f -name "$i" 2>/dev/null | head -1 | xargs -I{} dirname {})
    if [ -n "$D" ]; then
        # pre ~/coding/arduino/libraries vezme celý root knižnice (napr. .../libraries/Wire/src -> .../libraries/Wire)
        LIBROOT=$(echo "$D" | grep -oE "$HOME/coding/arduino/libraries/[^/]+")
        if [ -n "$LIBROOT" ]; then
            DIRS="$DIRS $LIBROOT"
        else
            DIRS="$DIRS $D"
        fi
        echo " + $i"
    fi
done
…a vytvorenie/naplnenie premennej DIRS, v ktorej neskôr vyhľadáva knižnice.
Samotné hľadanie knižníc a vytvorenie TAGS:
V aktuálnom projekte vyhľadá hlavičkové súbory uvedené v direktívach #include. Na základe nich nájde príslušné knižnice a zahrnie ich zdrojové súbory do indexu.
find $DIRS -type f \( -name "*.ino" -o -name "*.h" -o -name "*.cpp" -o -name "*.c" \) 2>/dev/null \
    | etags -o ./TAGS -
Takže na konci dňa máme súbor TAGS s požadovaným indexom.
Konkrétna ukážka
Spustím v adresári projektu príkaz time make tags a toto je výstup:
(Príkaz time nie je potrebný, ale chcel som ukázať, ako je to rýchle 😀.)
~/coding/arduino/projecttags/ptags.sh industrialshields/hardware/avr
Projekt: bf-220.ino, a jeho nainkludované knižnice
 (v /home/richard/coding/arduino/libraries a
 /home/richard/.arduino15/packages/industrialshields/hardware/avr):
 + Arduino.h
 + blink-tf.h
 + debounce-tf.h
 + EEPROM.h
 + IS.h
 + LiquidCrystal_I2C.h
 + mduino58plus-pinout.h
 + menu.h
 + Wire.h
Hotovo. TAGS má teraz 2118 riadkov.

0.346 secs
Funguje to výborne. Môžem skákať nielen na svoje vlastné funkcie a premenné, ale v prípade potreby aj do ostatných knižníc.
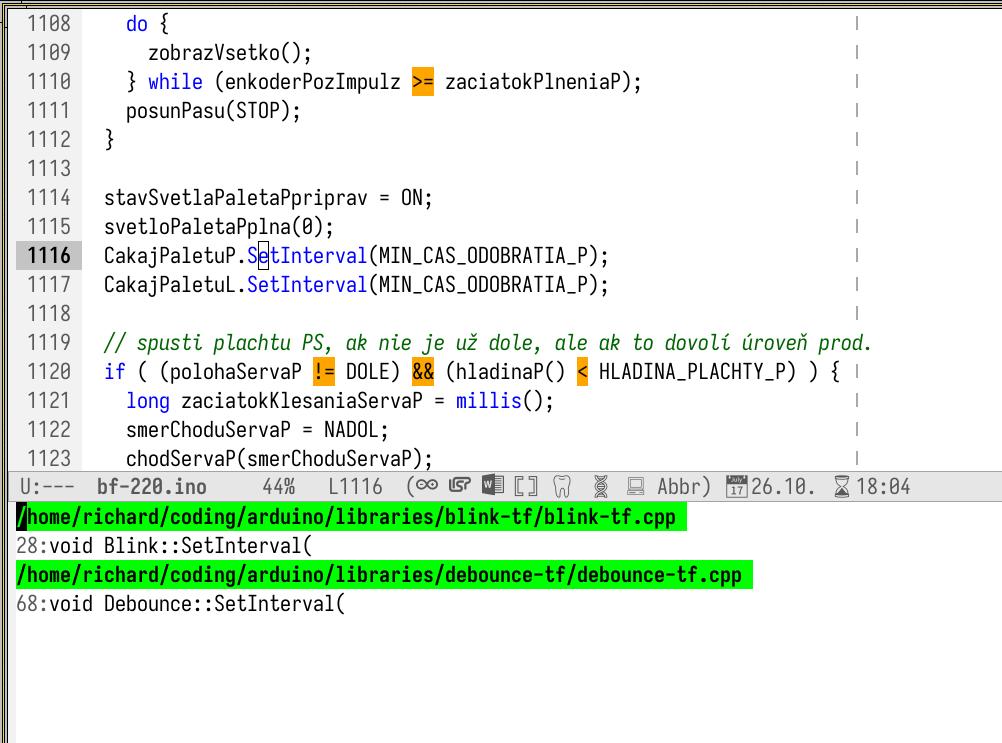
Nasledujúci obrázok ukazuje situáciu, keď som zavolal funkciu skoku, pričom som kurzor mal na slove setInterval.
Následne si z menu nižšie môžem vybrať v ktorej knižnici sa nachádza (lebo metóda s týmto názvom je v dvoch):
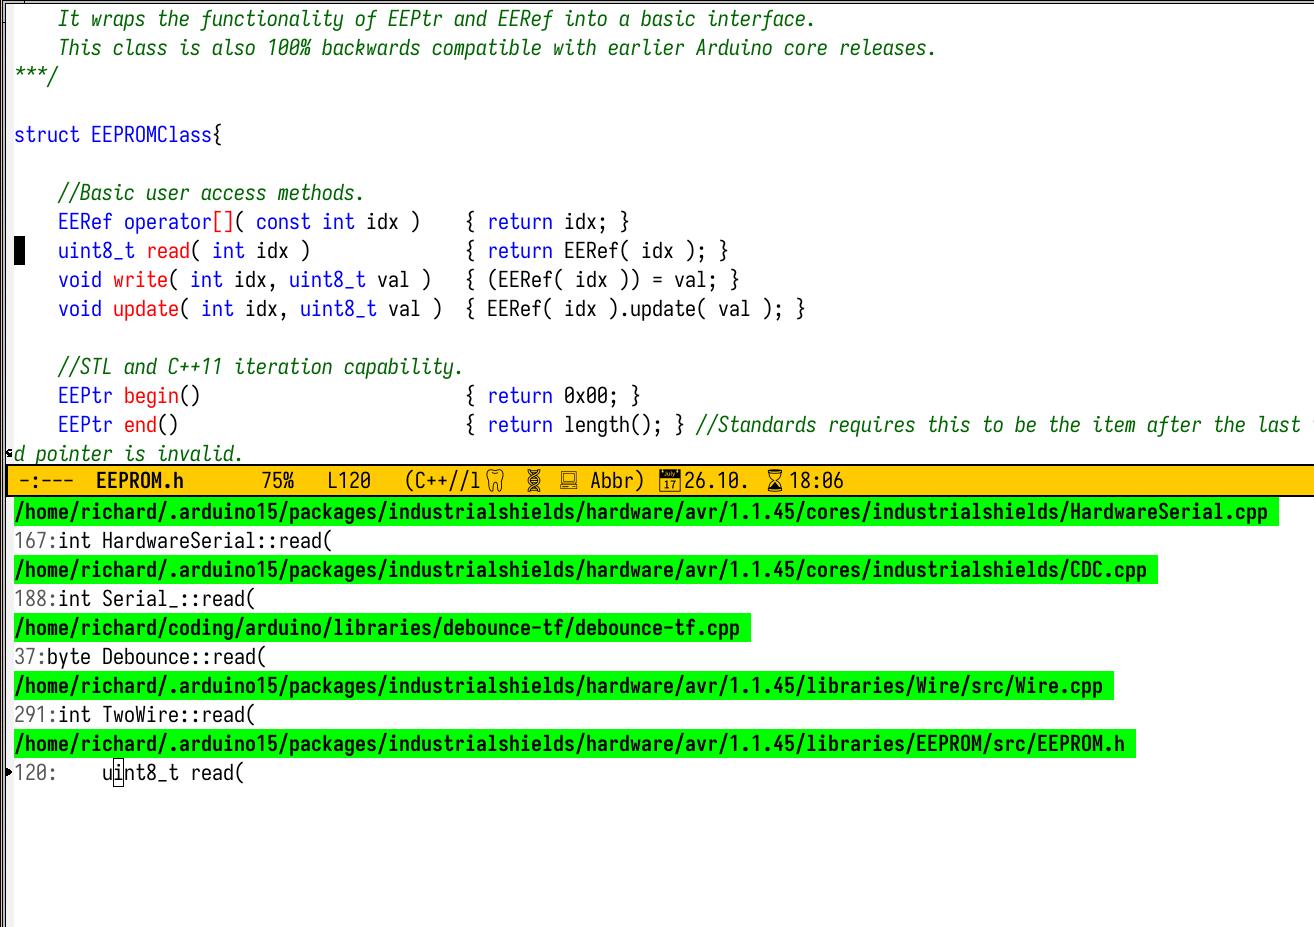
Podobná situácia pri voľbe metódy read, ktorá sa nachádza v rôznych knižniciach, ale mňa zaujíma systémový EEPROM.
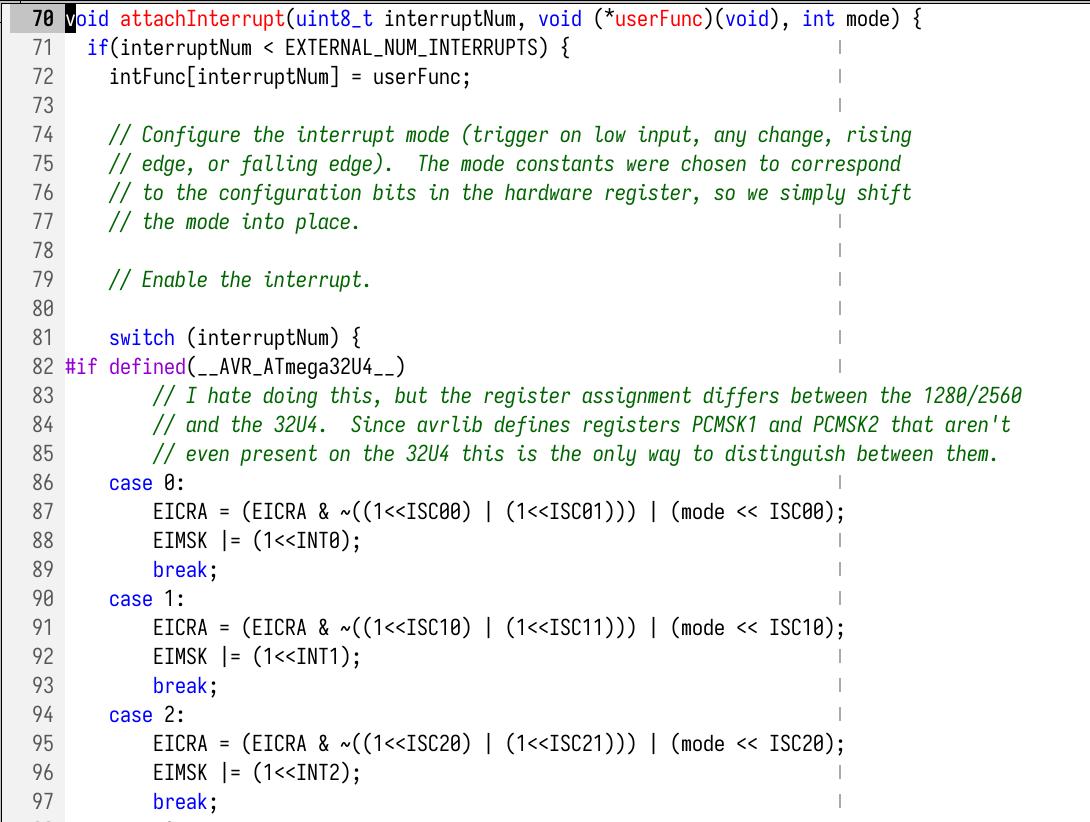
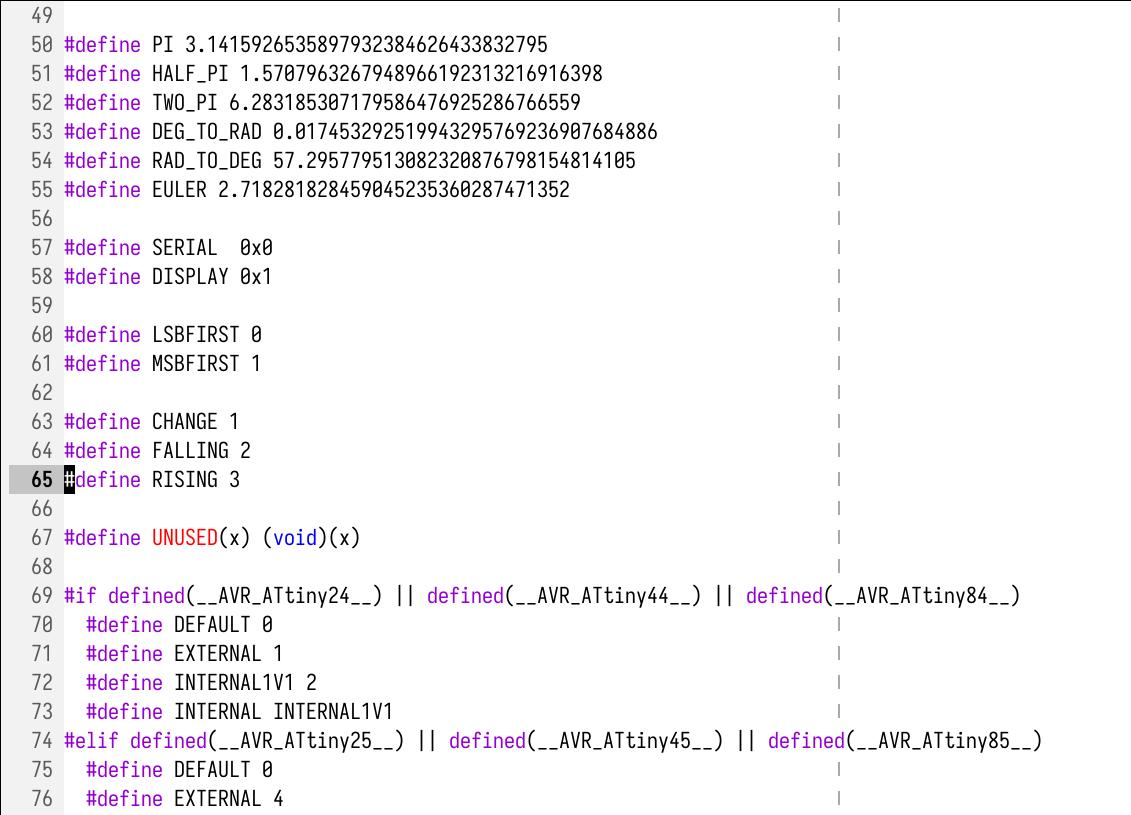
A skoky do systémových knižníc, konkrétne Arduino.h, v jednej je napríklad práca s prerušením, v druhej definícia makra RISING.
Tie skoky aj pri takto veľkom TAGS sú okamžité. Ak by bolo značiek nad 500 tisíc (čo je neoverená informácia), potom by stálo za zmienku nejaká optimalizácia.
Ešte doplním, že v Emacse sa skok na pôvodné miesto zabezpečí stlačením C-<space> C-<space>, prípadne sa dá cyklovať medzi historickými rozloženiami okien pomocou rozšírenia winner a jeho klávesových skratiek.
TAGS pre nepodporované jazyky a iné
ctags resp. etags podporuje veľké množstvo jazykov. Ak tam chýba nejaký exotický, dá sa doplniť. Napríklad pre Tcl používam túto konštrukciu:
etags -l none -r '/proc[ \t]+\([^ \t]+\)/\1/'
Ten regulárny výraz som vytvoril ešte pred dobou LLM. 😀
Emacs ale aj iné IDE majú aj iné formy skokov na definície, častokrát je to zabudované out-of-box, ale funguje to len pre súbory v rámci projektu. Len námatkou v Emacse máme occur, noccur a kdejaké grep-y. Alebo tzv. imenu, čo je prehľad pomenovaných prvkov v aktuálnom súbore.
Záver
TAGS a tags predstavujú jednoduchý, ale užitočný nástroj na orientáciu v zdrojovom kóde. Umožňujú rýchlo vyhľadávať definície funkcií, premenných a ďalších symbolov bez nutnosti manuálne prehľadávať jednotlivé súbory.
Zmysel majú najmä pri väčších projektoch s množstvom zdrojových súborov v externých knižniciach.
Pochopiteľne, vytvorenie indexu možno automatizovať a jeho používanie nevyžaduje zložité nástroje ani náročnú konfiguráciu. Opäť tá unixová krása — reťazenie jednoduchých nástrojov.
Pre pridávanie komentárov sa musíte prihlásiť.